// Projet
Anonymiser avant d'inférer
Une gateway LLM qui retire les données personnelles des prompts avant le modèle, les remet dans la réponse et trace chaque appel sans garder le texte. Mesures à l'appui.
- Publié
- Lecture
- 13 min
Sommaire
- Le problème
- Une gateway devant tous les modèles
- Construire ou réutiliser
- Masquer, traiter puis reconstruire
- Apprendre le français à Presidio
- Deux bugs en chemin
- À l’usage
- Un appel ordinaire
- Ce que le modèle reçoit
- Les règles s’appliquent d’office
- Les chiffres
- La preuve : un test de non-fuite en CI
- Les limites
- La suite
Prenez une entreprise de 200 personnes où chaque équipe s’est mise aux LLM dans son coin. L’une utilise une clé d’API qui circule de projet en projet. Une autre serait bien incapable de dire combien elle dépense. Le service client, lui, colle dans ses prompts les messages des clients tels quels, avec leur nom, leur adresse et parfois leur IBAN.
Pour remettre de l’ordre, j’ai construit une gateway, c’est-à-dire un point de passage unique entre les équipes et les modèles. Chaque appel passe par elle. Elle vérifie qui appelle et ce qu’il lui reste de budget, retire les données personnelles du texte avant de l’envoyer au modèle, puis les remet en place dans la réponse. Elle garde aussi une trace de chaque appel avec son coût, sans jamais conserver le texte lui-même.
L’entreprise est inventée. Le code, lui, tourne vraiment, avec des modèles open source sur ma propre machine, et chaque chiffre de cet article se reproduit avec une commande du repo.
Données masquées
99,2%
Sur 508 noms, adresses, IBAN et numéros répartis dans 100 textes de test.
Temps ajouté
+10ms
Par requête, en médiane. Le modèle met, lui, entre 0,7 et 3 secondes à répondre dans la démo.
Plus rapide qu'un LLM
~900×
9 ms par texte pour Presidio, plus de 8 secondes pour un modèle local de 7 milliards de paramètres, qui en trouve moins.
Donnée personnelle dans les logs
0
Vérifié à chaque modification du code.
Le problème
Envoyer un prompt à un modèle, c’est un peu comme envoyer un courrier à un prestataire. Ce qu’il contient se retrouve chez lui, dans ses archives, et chez tous ceux qui manipulent le courrier en chemin. Pour un LLM, ces archives s’appellent les journaux du serveur et les outils de suivi.
On pourrait interdire les données personnelles dans les prompts, mais ça ne tient pas longtemps. Un conseiller du service client répond à des personnes. Pour rembourser une commande, il lui faut le nom du client, son adresse et son numéro de compte. Sans eux, il n’a plus rien à traiter.
Le modèle, en revanche, n’a pas besoin de savoir que la cliente s’appelle Marie Dupont. Pour rédiger sa réponse, il lui suffit de savoir qu’il y a une personne, une adresse et un compte, et de pouvoir y faire référence. Toute l’idée est là. Avant l’envoi, on remplace chaque donnée par une étiquette, un peu comme on caviarde un document, mais en gardant de côté la correspondance entre les étiquettes et les vraies valeurs. Quand la réponse revient, on remet chaque valeur à sa place.
Voici ce que ça donne de bout en bout, avec la commande just demo du repo.
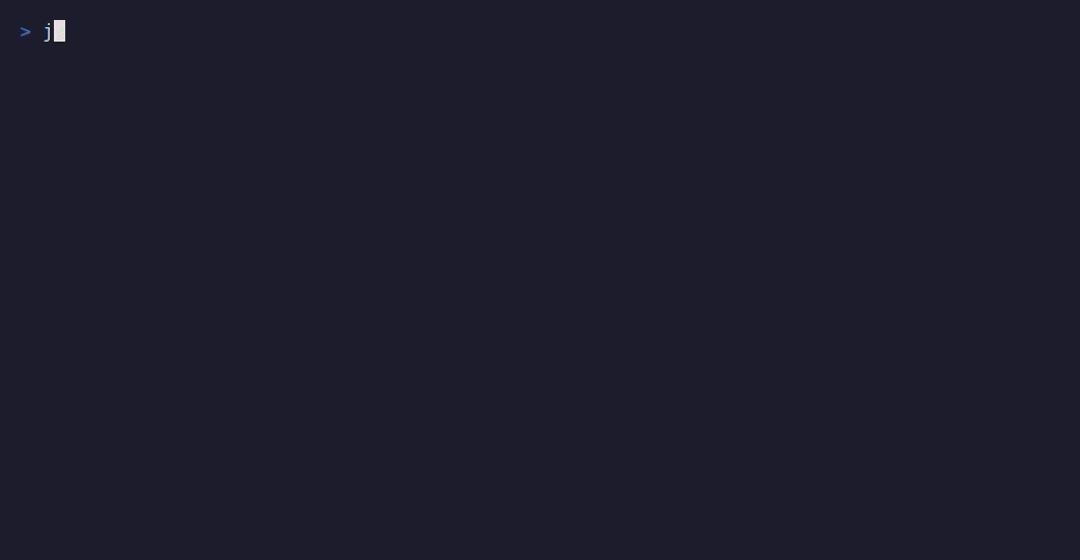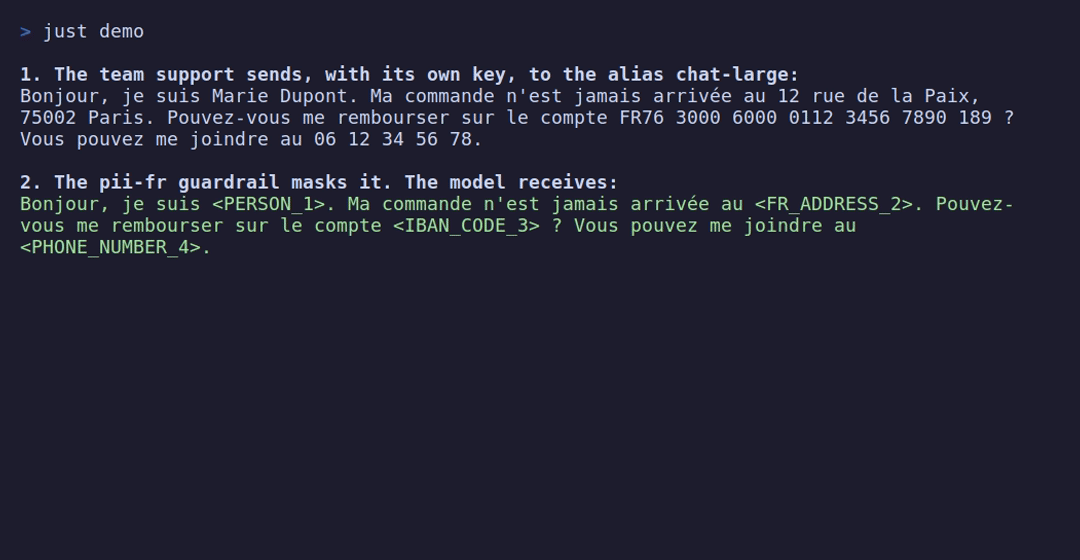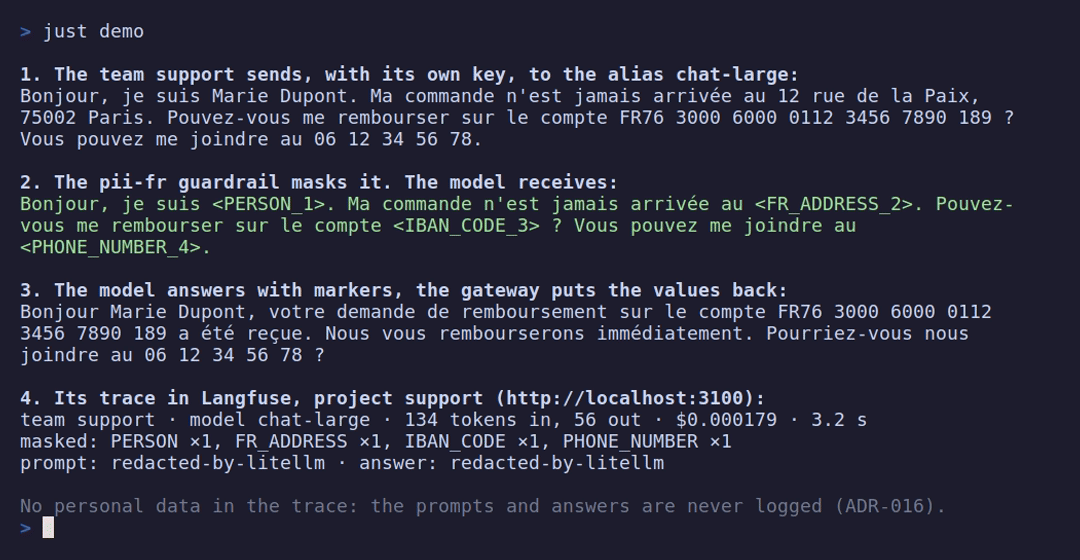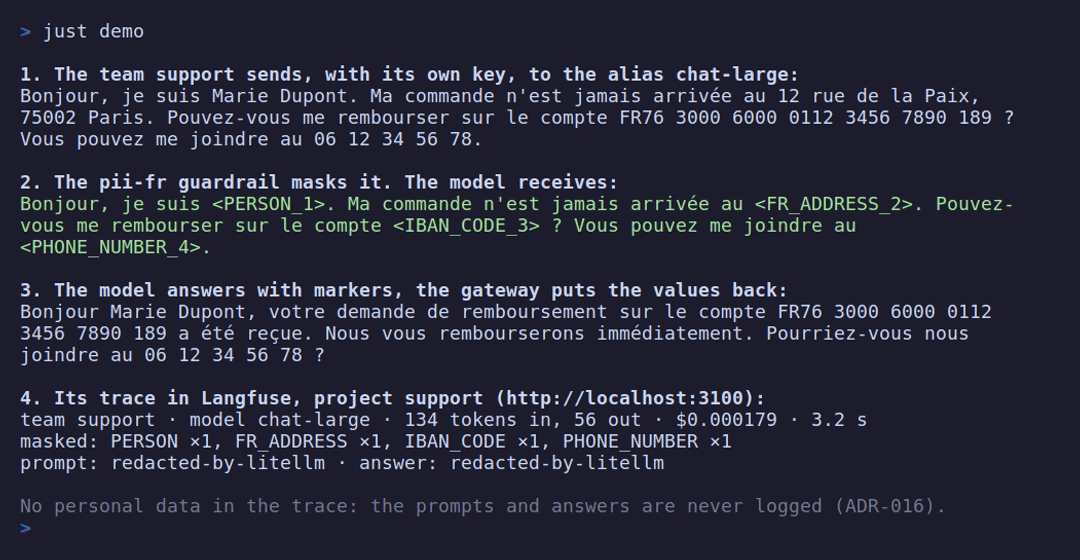
L’équipe envoie son message (1). Le modèle ne reçoit que des étiquettes comme <PERSON_1> (2). La réponse revient à l’équipe avec les vraies valeurs (3). Quant à la trace enregistrée, elle ne contient que l’équipe, le coût, la durée et le nombre de données masquées (4).
Une gateway devant tous les modèles
Plutôt que de demander à chaque équipe de faire attention, je voulais une seule porte d’entrée vers les modèles, où les règles s’appliquent d’office.
Les équipes appellent donc une adresse unique, qui parle le même langage que l’API d’OpenAI, ce qui fait que leur code change à peine. Chacune a sa propre clé, avec son budget et son quota. Elles ne demandent jamais un modèle par son nom, mais un usage : chat-small pour des réponses rapides, chat-large pour des réponses plus soignées, embed pour la recherche dans des documents. Si un meilleur modèle sort demain, la plateforme le branche derrière le même nom et personne n’a rien à modifier.
Construire ou réutiliser
La question s’est posée très tôt. Écrire ma propre gateway était tentant, puisque j’aurais eu exactement ce dont j’avais besoin et rien de plus. Seulement, la liste de ce qu’elle devait savoir faire s’allongeait vite : des clés par équipe, des budgets, des quotas, la bascule vers un autre modèle quand le premier tombe, un prix par token, les réponses en streaming, le suivi de chaque appel. Ça représentait des mois de travail pour un outil qui n’est qu’un moyen. Ce que je voulais montrer, c’est la plateforme qui se construit autour.
J’ai comparé cinq options, de la gateway maison aux offres SaaS, et j’ai retenu LiteLLM Proxy, un projet open source très utilisé qui couvre presque tout le besoin. Le raisonnement complet est dans l’ADR, la fiche où je consigne chaque décision d’architecture avec les options écartées.
Décision : LiteLLM Proxy comme gateway LLM
LiteLLM est la seule option qui gère les clés, les budgets, la bascule entre modèles, le masquage et le suivi sans licence payante, et qui tourne de la même façon en local et sur Kubernetes. Envoy AI Gateway ne sait ni donner une clé à chaque équipe ni compter un budget en euros. Kong réserve le masquage à sa version Enterprise. Une gateway SaaS, enfin, ferait sortir les prompts de l’entreprise avant même qu’on ait pu les masquer. Au final, le code que j’ai écrit autour de LiteLLM tient en une classe de 85 lignes, deux scripts d’initialisation et deux fichiers de configuration.
Masquer, traiter puis reconstruire
À chaque appel, trois étapes s’enchaînent.
- Masquer. Avant d’envoyer quoi que ce soit, LiteLLM confie le texte à Presidio, un outil open source de Microsoft qui repère les données personnelles. Chaque donnée trouvée est remplacée par une étiquette numérotée, et LiteLLM garde la correspondance en mémoire.
- Traiter. Le modèle travaille sur le texte masqué. Il voit
<PERSON_1>là où il y avait un nom et peut l’utiliser dans sa réponse comme n’importe quel autre mot. - Reconstruire. Quand la réponse revient, LiteLLM remplace chaque étiquette par sa vraie valeur. L’équipe reçoit une réponse tout à fait normale.
Envoyé par l'équipe
Bonjour, je suis Marie Dupont. Ma commande n'est jamais arrivée au 12 rue de la Paix, 75002 Paris. Pouvez-vous me rembourser sur le compte FR76 3000 6000 0112 3456 7890 189 ?
Reçu par le modèle
Bonjour, je suis <PERSON_1>. Ma commande n'est jamais arrivée au <FR_ADDRESS_2>. Pouvez-vous me rembourser sur le compte <IBAN_CODE_3> ?
Les dates, elles, restent visibles, et c’est voulu. Une date de commande ou de livraison sert souvent à la réponse, et une date seule ne permet d’identifier personne.
Apprendre le français à Presidio
Presidio reconnaît beaucoup de choses en anglais, mais rien de spécifiquement français : ni le numéro de sécurité sociale, ni le numéro fiscal, ni la forme de nos adresses. Son modèle de langue anglais passe aussi à côté de la plupart des noms et des villes françaises. J’ai donc ajouté un modèle de langue français et écrit des recognizers, de petits détecteurs spécialisés, un par type de donnée.
Quand un identifiant porte une clé de contrôle, comme le NIR ou l’IBAN, le recognizer la vérifie. C’est ce qui évite de prendre le premier nombre de 13 chiffres venu pour un numéro fiscal.
Les noms ont été le plus difficile. Un modèle de langue rate un nom quand rien autour ne l’annonce, en tête de lettre ou dans une signature. Le recognizer de noms s’appuie donc sur les indices qu’un humain remarquerait : un titre (M., Docteur), un champ de formulaire (Nom :), ou un prénom connu, parmi les 5 114 prénoms donnés à au moins 500 enfants en France depuis 1900 d’après l’INSEE.
Rien de tout ça n’est réservé au français. Presidio travaille langue par langue, et l’Analyzer de la gateway charge d’ailleurs déjà un modèle anglais à côté du français. Ajouter l’allemand ou l’espagnol revient à charger le modèle de langue correspondant et à écrire les recognizers des identifiants du pays.
Deux bugs en chemin
En testant sur de vrais textes français, je suis tombé sur deux bugs de LiteLLM dans la numérotation des étiquettes. Le premier sautait aux yeux. Quand une adresse et la ville qu’elle contient étaient détectées toutes les deux, les étiquettes se mélangeaient en un FR_ADDRESS_2ON_4 illisible.
Le second était plus sournois. Chaque message d’une conversation était numéroté à partir de 1, si bien que la personne citée dans le premier message et celle citée dans le second devenaient toutes les deux <PERSON_1>. Au moment de reconstruire, la réponse mettait un nom à la place de l’autre, sans la moindre erreur visible.
Les deux bugs sont signalés chez LiteLLM (#42130, #31959) et toujours ouverts. En attendant leur correction, je les contourne dans une petite sous-classe qui ne remplace qu’une seule méthode. Des tests vérifient qu’elle reste compatible avec la version de LiteLLM utilisée (ADR-015).
À l’usage
Pour les équipes, tout ça reste invisible. Elles appellent la gateway comme elles appelleraient l’API d’OpenAI, avec la clé de leur équipe, et reçoivent des réponses normales. Trois appels suffisent à en faire le tour. Ils se lancent tels quels une fois la gateway démarrée avec just gateway-up. TEAM_KEY contient la clé du service client et MASTER_KEY celle de l’équipe plateforme. Les deux se trouvent dans le fichier .env, sous les noms TEAM_KEY_SUPPORT et LITELLM_MASTER_KEY.
Un appel ordinaire
L’équipe demande un usage, chat-large, plutôt qu’un modèle. Son message contient un nom et un IBAN, et la réponse revient avec les deux, comme si de rien n’était.
curl -s localhost:4000/v1/chat/completions \
-H "Authorization: Bearer $TEAM_KEY" \
-H 'content-type: application/json' \
-d '{"model": "chat-large", "temperature": 0, "messages": [{"role": "system", "content": "Tu es le service client. Recopie les étiquettes entre chevrons telles quelles."}, {"role": "user", "content": "Écris à Marie Dupont, en une phrase qui commence par Bonjour et son nom, que son remboursement part sur le compte FR76 3000 6000 0112 3456 7890 189."}]}' \
| jq -r '.choices[0].message.content'
Bonjour Marie Dupont, votre remboursement est en cours d'approbation et sera versé sur le compte IBAN : FR76 3000 6000 0112 3456 7890 189.
import os
from openai import OpenAI

client = OpenAI(base_url="http://localhost:4000", api_key=os.environ["TEAM_KEY"])
answer = client.chat.completions.create(
  model="chat-large",
  temperature=0,
  messages=[
      {"role": "system", "content": "Tu es le service client. Recopie les étiquettes entre chevrons telles quelles."},
      {"role": "user", "content": "Écris à Marie Dupont, en une phrase qui commence par Bonjour et son nom, que son remboursement part sur le compte FR76 3000 6000 0112 3456 7890 189."},
  ],
)
print(answer.choices[0].message.content)
Le message système demande au modèle de recopier les étiquettes sans y toucher. Sans lui, dans mes essais, le petit modèle de la démo les réécrivait souvent à sa façon, et une étiquette abîmée ne peut plus être remplacée par la vraie valeur.
Ce que le modèle reçoit
L’équipe plateforme peut lancer le masquage seul, sans appeler de modèle, pour voir exactement ce qui part. C’est ce que fait just demo pour afficher le texte masqué.
curl -s localhost:4000/guardrails/apply_guardrail \
-H "Authorization: Bearer $MASTER_KEY" \
-H 'content-type: application/json' \
-d '{"guardrail_name": "pii-fr", "text": "Écris à Marie Dupont, en une phrase qui commence par Bonjour et son nom, que son remboursement part sur le compte FR76 3000 6000 0112 3456 7890 189."}' \
| jq -r .response_text
Écris à <PERSON_1>, en une phrase qui commence par Bonjour et son nom, que son remboursement part sur le compte <IBAN_CODE_2>.
Les règles s’appliquent d’office
Chaque équipe n’a accès qu’aux usages prévus pour elle. Si l’équipe du service client demande embed, le modèle de recherche dans les documents dont elle n’a pas l’usage, la gateway refuse avant même de contacter un modèle. Un budget mensuel dépassé ou trop de requêtes par minute donnent le même genre de refus.
curl -s localhost:4000/v1/embeddings \
-H "Authorization: Bearer $TEAM_KEY" \
-H 'content-type: application/json' \
-d '{"model": "embed", "input": "Bonjour"}' \
| jq -r .error.message
team not allowed to access model. This team can only access models=['chat-small', 'chat-large']. Tried to access embed
Les chiffres
Pour savoir si le masquage tient la route, il me fallait des textes dont je connaissais d’avance chaque donnée personnelle. J’ai généré 100 textes français fictifs (lettres, emails, messages, formulaires) qui en contiennent 508, toutes annotées.
Restait une question qu’on me poserait forcément : pourquoi ne pas demander directement à un LLM de trouver les données personnelles ? J’ai donc fait passer le même test à trois modèles locaux de taille croissante, face à Presidio. Tout tourne sur un processeur i7-14700KF, sans carte graphique.
| Détecteur | Précision (%) | Rappel (%) | Entièrement masqué (%) | Temps par texte (ms) |
|---|---|---|---|---|
| Presidio + recognizers FR | 88,1 | 99 | 99,2 | 9 |
| qwen2.5:0.5b | 46,9 | 9,1 | 16,9 | 538 |
| qwen2.5:1.5b | 77,2 | 36 | 40,2 | 1 592 |
| qwen2.5:7b | 91,1 | 78,9 | 82,7 | 8 239 |
Deux mots de vocabulaire pour lire ce tableau. Le rappel indique la part des données personnelles qui ont été trouvées. La précision indique, parmi tout ce que l’outil a signalé, la part qui était vraiment une donnée personnelle. La colonne Entièrement masqué est la plus parlante : c’est la part des données dont plus aucun caractère n’atteint le modèle, même quand l’outil s’est trompé de catégorie. Une adresse prise pour une ville reste cachée, et c’est tout ce qui compte ici.
Le plus petit modèle ne trouve presque rien. Même le plus gros, avec ses 7 milliards de paramètres, laisse passer environ une donnée sur six, et il lui faut plus de 8 secondes par texte quand Presidio s’en sort en 9 millièmes. L’écart se creuse sur les identifiants structurés. Un IBAN suit des règles strictes et porte une clé de contrôle, qu’une règle vérifie à coup sûr et qu’un LLM ne peut que deviner : le 7b ne retrouve que 40 % des IBAN. Il prend l’avantage sur un seul point, la précision sur les noms. Quand il signale un nom, c’en est presque toujours un (99 %, contre 82 % pour Presidio), mais il en oublie beaucoup plus. Pour ce travail précis, un outil spécialisé et des règles bien écrites font mieux qu’un modèle généraliste, pour une fraction du coût.
Le premier passage de Presidio n’était pas aussi bon. Il laissait 31 données en clair : des noms sans contexte, des adresses coupées sur deux lignes, et des cartes Mastercard récentes, dont les numéros commencent par 2 et que Presidio ne connaissait pas. Trois corrections ont fait passer le taux de 93,9 % à 99,2 %. Il restait un doute, celui d’avoir simplement appris ces 100 textes par cœur. J’ai donc généré un second jeu avec une autre graine aléatoire, sans jamais m’en servir pour régler les recognizers. Il passe de 94,1 % à 99,4 %, ce qui montre que les corrections tiennent aussi sur des textes qu’elles n’avaient jamais vus.
Et le temps perdu ? Le masquage ajoute 10 millisecondes par requête en médiane (14,8 ms au lieu de 4,8 ms), mesurées avec une réponse simulée pour isoler son coût. À côté d’un modèle qui met une à plusieurs secondes à répondre, ça ne se remarque pas.
La preuve : un test de non-fuite en CI
Un bon score au benchmark ne suffit pas. Il mesure Presidio isolé, alors qu’en conditions réelles, une donnée peut s’échapper ailleurs : dans un journal technique un peu trop bavard, ou dans une trace qui garde le texte du prompt. C’est d’ailleurs ce qui s’est produit pendant mes premiers essais de suivi. La toute première trace contenait « Bonjour Marie Dupont » en clair, parce que les vraies valeurs sont remises dans la réponse avant que LiteLLM ne l’enregistre. Depuis, les traces ne gardent plus aucun message.
Pour vérifier ce qui sort réellement, j’ai écrit un test qui rejoue les 100 textes à travers la gateway, comme le ferait une équipe, puis cherche chaque donnée à trois endroits :
- dans ce que reçoit le modèle, en relançant LiteLLM en mode
DEBUGle temps du test, le seul niveau où il journalise le corps exact envoyé à Ollama ; - dans les traces Langfuse de ces appels ;
- dans les journaux de LiteLLM et d’Ollama, à leur niveau habituel.
Le test est volontairement sévère, puisqu’une donnée compte comme fuite dès qu’un seul de ses mots passe. C’est ce qui a révélé le cas d’Alexandrie Toussaint. Presidio avait pris le prénom Alexandrie pour la ville et l’avait masqué comme un lieu, mais le nom de famille restait visible : <LOCATION_1> Toussaint. En cherchant le nom complet, le test n’aurait rien vu.
| Où | Avec le masquage | Sans le masquage |
|---|---|---|
| Texte reçu par le modèle | 3 | 1 512 |
| Traces Langfuse | 0 | 0 |
| Journaux de LiteLLM et d'Ollama | 0 | 0 |
Les trois mots qui passent encore sont les trois ratés déjà connus du benchmark : Toussaint, Paris et Caen. Ils sont listés dans le test, qui échoue si un nouveau raté apparaît, mais aussi si l’un d’eux disparaît, pour que la liste reste juste. Pour m’assurer que le test sait vraiment repérer une fuite, je l’ai regardé échouer en provoquant chaque fuite à la main : en coupant le masquage, en réactivant l’enregistrement des messages dans les traces, puis en passant LiteLLM en mode verbeux. Il tourne désormais à chaque pull request, dans un job dédié de la CI.
just test -m leakcollected 311 items / 309 deselected / 2 selected test_no_leak.py::test_traces_and_logs_hold_no_personal_data PASSED [ 50%] test_no_leak.py::test_the_model_receives_only_the_known_misses PASSED [100%] ========== 2 passed, 309 deselected in 108.03s (0:01:48) ==========
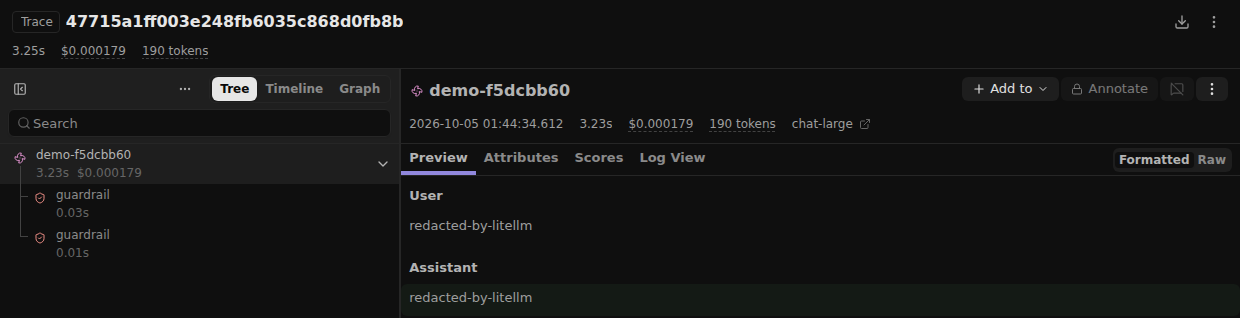
Les traces gardent tout ce qui sert à piloter : l’équipe, le modèle, le nombre de tokens, la durée et le coût de chaque appel. Le texte, lui, est remplacé par redacted-by-litellm. Chaque responsable d’équipe ne voit que les appels de son équipe.
Les limites
- Presidio rate encore des données. Une ville citée sans contexte ou un prénom trop rare pour la liste de l’INSEE peuvent passer. Comme les 100 textes viennent des mêmes modèles de documents, d’autres types de documents feront sûrement apparaître d’autres ratés.
- Le modèle doit recopier les étiquettes telles quelles.
qwen2.5:1.5boublie parfois les chevrons et écritPERSON_1, ou les remplace par des crochets. L’étiquette abîmée n’est alors pas reconnue et reste dans la réponse. Une consigne dans le prompt système a suffi dans mes essais, mais je n’ai pas encore mesuré la fréquence du problème. - Les réponses en streaming arrivent d’un bloc. Une étiquette peut être coupée entre deux morceaux de réponse, alors LiteLLM attend la réponse entière avant de remettre les valeurs.
- Certaines fonctions de LiteLLM sont payantes. Activer le masquage équipe par équipe en fait partie. Je l’ai donc activé pour tout le monde par défaut, et les équipes qui n’en ont pas besoin en sont retirées par une option que seule l’équipe plateforme peut modifier.
La suite
Cette gateway est le premier bloc d’une plateforme IA interne. Le deuxième la déploie sur Kubernetes, dans llmops-platform, avec vLLM à la place d’Ollama, Envoy Gateway en entrée et les clés rangées dans un gestionnaire de secrets. Le troisième sera son premier vrai client, un agent qui s’appuie sur une base documentaire et dont la qualité est évaluée à chaque modification. Chacun aura son article.
D’ici là, deux chantiers comptent plus que les autres : réduire les ratés de Presidio et fiabiliser la recopie des étiquettes, parce que ce sont eux qui décident de ce qui atteint vraiment le modèle.
Si vous voulez voir tout ça tourner, le code, les décisions d’architecture et le benchmark sont sur GitHub. Deux commandes suffisent : just gateway-up, puis just demo.